Este é o nono e último artigo da série sobre arquitetura amigável para IA. Ao longo da série, falamos sobre contexto, documentação, observabilidade de sistemas, habilidades, agentes, ferramentas, MCP, segurança e o fluxo completo para entregar uma funcionalidade.
Para encerrar, quero olhar para dentro da própria ferramenta de IA.
Quando um agente participa de uma tarefa, normalmente observamos apenas o resultado final. O pull request foi criado? Os testes passaram? A funcionalidade foi entregue?
Essas perguntas são importantes, mas não explicam o caminho percorrido pelo agente.
Quanto tempo levou para encontrar o contexto correto? Quantas vezes a investigação foi repetida? Quais ferramentas foram usadas? Quando foi necessária aprovação? O problema estava no modelo, na documentação, na integração ou no próprio fluxo?
Sem esses sinais, toda avaliação se baseia em impressões.
O trabalho do agente também precisa ser observável
Em sistemas tradicionais, já sabemos que logs, métricas e traces ajudam a explicar o comportamento de uma aplicação. Não consideramos uma API confiável apenas porque ela respondeu uma vez. Observamos latência, erros, dependências, tráfego e impacto.
Com agentes, muitas equipes ainda fazem o oposto. Avaliam a ferramenta por meio de algumas interações isoladas e decidem que ela é rápida, lenta, boa ou ruim.
Uma sessão de agente também é um fluxo distribuído. Ela envolve modelo, contexto, ferramentas, permissões, sistemas externos, arquivos, testes e decisões humanas. O resultado final é apenas o último evento dessa cadeia.
Se queremos melhorar esse fluxo, precisamos enxergar o que acontece antes do resultado final.
O que vale a pena medir?
Observabilidade não significa registrar tudo. O objetivo não é vigiar desenvolvedores nem transformar contagem de tokens em uma falsa medida de produtividade.
O objetivo é criar evidências para decisões de engenharia.
Alguns sinais úteis incluem:
quantidade e duração das sessões;
tempo gasto em chamadas ao modelo e às ferramentas;
tokens usados e custo estimado;
erros, novas tentativas e interrupções;
quantidade de solicitações de aprovação;
testes executados e seus resultados;
arquivos ou linhas alterados;
resultado da tarefa, como um pull request criado, uma alteração interrompida ou uma entrega concluída.
Esses sinais se tornam úteis quando os conectamos a perguntas reais.
A nova documentação reduziu o tempo até a primeira hipótese útil? Uma habilidade de investigação reduziu a quantidade de chamadas às ferramentas? Um MCP externo está adicionando latência sem melhorar o resultado? O agente está pedindo aprovação cedo ou tarde demais? Uma mudança de contexto aumentou o custo porque adicionou informação útil ou porque adicionou ruído?
Não conseguimos responder a essas perguntas olhando apenas para a resposta final do agente.
Uma boa métrica nem sempre é a mais fácil de contar. É aquela que ajuda a entender uma decisão ou encontrar uma oportunidade de melhoria.
OpenTelemetry como camada comum
Este artigo usa OpenTelemetry porque ele é um padrão aberto e um projeto open source. Podemos começar sem pagar por uma plataforma proprietária de observabilidade.
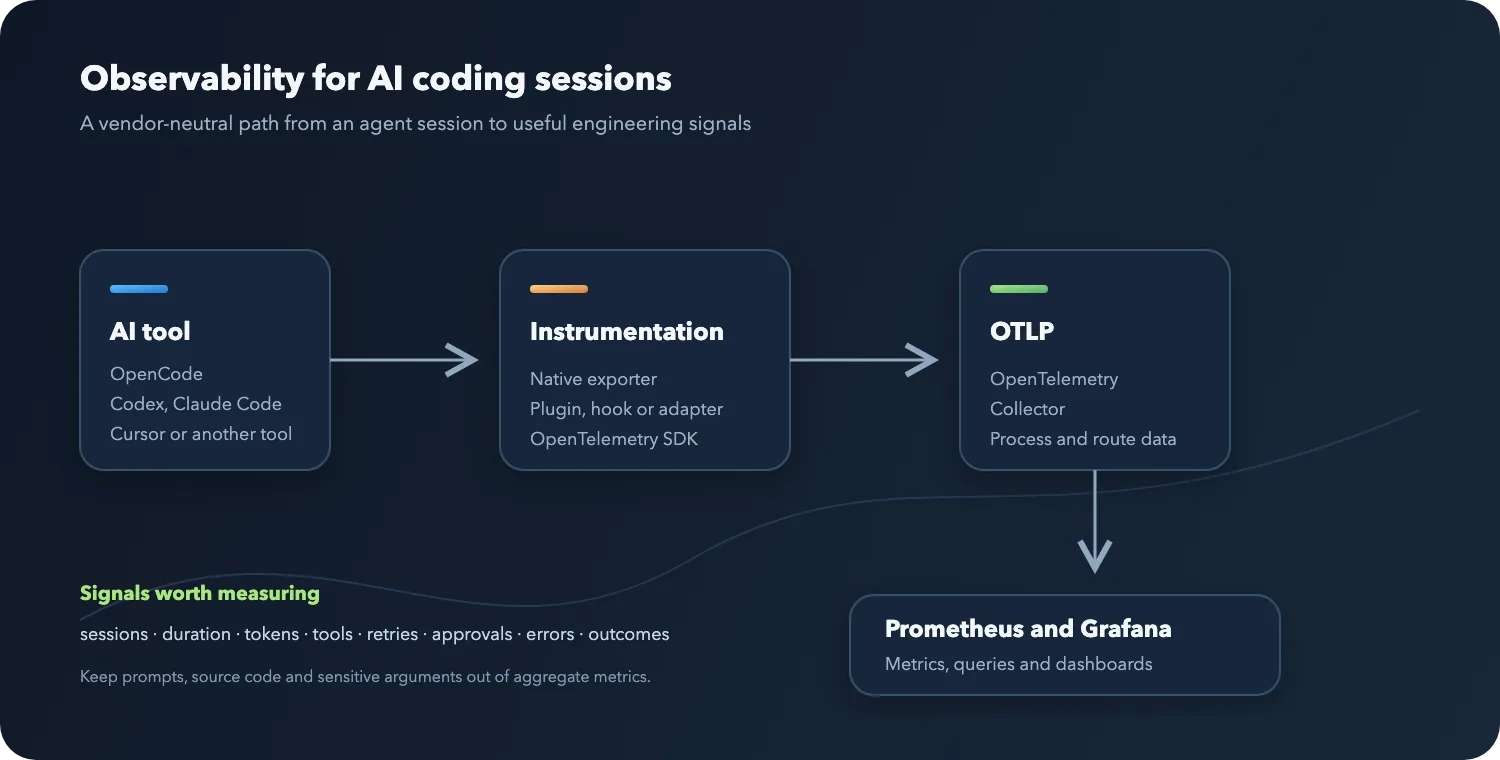
Uma arquitetura possível usa um OpenTelemetry Collector para receber e encaminhar sinais, Prometheus para armazenar métricas e Grafana para consultá-las. Esses componentes são gratuitos e open source, embora o modelo usado pela ferramenta ou uma plataforma gerenciada possa ter seus próprios custos.
O ponto mais importante não é a escolha do dashboard. É a separação entre a ferramenta que produz eventos e o sistema que os observa.
OpenCode é apenas o exemplo usado neste artigo. Ele pode ser instrumentado por um plugin que exporta sinais por OTLP. A mesma arquitetura pode ser usada com Codex, Claude Code, Cursor ou outra ferramenta que tenha um exportador nativo, plugin, hook ou adaptador capaz de produzir telemetria.
Cada ferramenta pode emitir eventos de uma maneira diferente. O backend não precisa conhecer todos esses detalhes. Ele pode trabalhar com conceitos mais estáveis, como sessão, chamada de modelo, ferramenta, aprovação, erro e resultado.
Essa separação permite trocar a ferramenta sem reconstruir toda a infraestrutura de observabilidade. Também permite comparar diferentes fluxos usando uma linguagem comum.
Da atividade aos resultados
Uma armadilha comum é observar apenas a atividade.
Mais mensagens nem sempre significam mais progresso. Mais tokens podem representar um contexto melhor, mas também podem indicar que o agente está perdido. Mais chamadas de ferramentas podem mostrar uma investigação cuidadosa ou falta de documentação.
Por isso, os sinais de atividade precisam ser conectados aos sinais de resultado.
| Atividade | Resultado que vale investigar |
|---|---|
| Tokens usados | A tarefa foi concluída com menos retrabalho? |
| Chamadas de ferramentas | O agente encontrou evidências melhores? |
| Duração da sessão | O tempo extra melhorou a qualidade ou apenas aumentou a espera? |
| Solicitações de aprovação | Os limites de autonomia eram adequados? |
| Linhas alteradas | Os testes e critérios de sucesso foram atendidos? |
Esse cuidado impede que a observabilidade se torne um placar. Não estamos julgando o agente pela maior quantidade possível de saída. Estamos tentando entender se o fluxo ajuda a equipe a tomar decisões melhores com segurança.
O contexto também aparece nas métricas
Os sinais da sessão podem revelar problemas que não estão no modelo.
Se o agente passa muito tempo procurando arquivos, a arquitetura de contexto pode ser difícil de navegar. Se ele repete consultas, pode estar faltando uma habilidade especializada. Se chamadas externas são lentas, a integração pode estar mal projetada. Se ele pede aprovação a cada passo, as permissões podem ser rígidas demais ou o fluxo pode não estar claro.
Essa é uma parte importante de uma arquitetura amigável para IA: contexto não é apenas algo que entregamos ao agente. Também é algo que podemos avaliar por meio do comportamento observado.
A telemetria fecha o ciclo entre contexto, execução e aprendizado.
Observabilidade também é segurança
A telemetria de agentes pode conter mais informação do que parece.
Um prompt pode conter uma regra interna. Um argumento de ferramenta pode conter um token. Um resultado pode incluir dados de clientes. Um trace pode registrar parte do código. Um caminho de arquivo pode revelar a estrutura de um sistema.
Por isso, não devemos confiar no próprio agente para decidir o que pode ser enviado ao backend. A proteção precisa ser aplicada por componentes determinísticos, como o Collector, o gateway de telemetria e as políticas de acesso.
Alguns princípios são importantes:
prompts completos não devem ser armazenados em métricas;
argumentos e resultados de ferramentas precisam ser sanitizados antes do envio;
caminhos de arquivos e conteúdo de código não devem virar labels;
credenciais devem ficar fora de configurações versionadas;
tokens para destinos gerenciados devem ter o menor privilégio possível;
retenção e acesso devem ser definidos antes do início da coleta;
identificadores de alta cardinalidade precisam ser tratados com cuidado.
Isso se conecta ao artigo sobre segurança, guardrails e fitness functions. Guardrails determinísticos não devem proteger apenas as ações do agente. Eles também precisam proteger os dados criados durante o trabalho do agente.
O caso do session_id
Durante uma investigação, pode ser útil abrir uma sessão e entender o que aconteceu nela. Uma implementação local pode permitir selecionar um session_id no Grafana para esse tipo de análise.
Isso é conveniente em um ambiente local, mas cada nova sessão pode criar uma nova série de métricas. Em uma operação com muitos usuários e execuções, esse crescimento de cardinalidade pode ser caro e difícil de sustentar.
Por isso, observabilidade para desenvolvimento é diferente de observabilidade para produção.
No desenvolvimento, manter o identificador pode facilitar o aprendizado. Em produção, pode ser melhor usar métricas agregadas e enviar traces ou logs sanitizados para um backend projetado para investigações individuais.
Um dashboard é uma ferramenta de investigação. Ele não deve ser tratado como autorização para coletar qualquer dado que quisermos.
Um laboratório que torna a ideia concreta
Para manter a discussão prática, criei o repositório agent-observability-with-opentelemetry.
Ele contém uma configuração local com OpenTelemetry Collector, Prometheus e Grafana, além de um dashboard inicial para sessões de agentes. OpenCode é usado como exemplo de instrumentação, mas o backend foi projetado para receber sinais de outras ferramentas também.
O repositório também documenta os limites do experimento. Logs e traces ficam desativados inicialmente porque podem conter prompts, código e argumentos sensíveis. A ideia é começar com um conjunto pequeno de métricas, entender o que realmente precisamos observar e só então ampliar a coleta.
Isso é mais saudável do que ativar todos os sinais disponíveis e descobrir tarde demais que criamos um novo problema de segurança.
Conclusão
Uma arquitetura amigável para IA não deve apenas fornecer contexto ao agente. Ela também precisa tornar o trabalho do agente observável.
Quando medimos sessões, duração, tokens, ferramentas, erros, aprovações e resultados, conseguimos discutir a evolução do fluxo com base em evidências. Podemos descobrir que o problema não é o modelo, mas a documentação. Podemos perceber que uma habilidade reduziu a exploração desnecessária. Podemos encontrar uma integração lenta ou uma etapa que pede revisão humana cedo demais.
O OpenTelemetry oferece uma forma aberta de começar. OpenCode foi apenas o exemplo usado neste artigo. A mesma separação entre ferramenta, instrumentação, Collector e backend pode dar suporte a outras ferramentas e modelos.
Este é o fim da série. A ideia central é simples: agentes melhores dependem menos de tentativa e mais de contexto, limites, evidências e feedback. A observabilidade mostra se estamos realmente melhorando.
Comentários