Este é o segundo artigo de uma série sobre arquitetura amigável à IA. No primeiro artigo, expliquei como a IA se parece com uma pessoa nova entrando em uma empresa e tentando entender um sistema pela primeira vez.
Agora quero explorar uma parte importante dessa comparação: onde essa pessoa encontra as informações de que precisa?
Código é apenas parte da história
Quando alguém novo entra em um time, normalmente começa pelo repositório. É lá que estão os serviços, endpoints, modelos, testes e regras de negócio.
Mas raramente o código responde a tudo.
Ele pode mostrar que uma decisão existe, mas não explicar por que foi tomada. Pode mostrar que dois serviços se comunicam, mas não deixar claro qual serviço é responsável por aquela função. Pode mostrar uma regra de negócio, mas não explicar quando ela se aplica ou o que acontece quando muda.
Para entender um sistema de verdade, é preciso combinar várias fontes:
código;
documentação;
decisões arquiteturais;
tickets e épicos;
incidentes anteriores;
dashboards e métricas;
conversas com os membros do time.
O mesmo vale para agentes de IA.
O problema é que, em muitas empresas, essas informações existem, mas não estão conectadas. O código está em um repositório. As decisões estão em uma ferramenta de documentação. Os tickets estão em outro sistema. Os incidentes estão em uma plataforma de operações. E o contexto mais importante ainda está na cabeça de poucas pessoas.
Ter informação não é o mesmo que ter contexto.
O que é uma arquitetura de contexto?
Gosto de pensar em Arquitetura de Contexto como uma forma de organizar e conectar as diferentes fontes de conhecimento que explicam um sistema.
Não se trata de criar um documento enorme com tudo o que a empresa sabe. Também não se trata de copiar toda a documentação para um banco vetorial e esperar a resposta aparecer.
Trata-se de criar caminhos que ajudem uma pessoa ou um agente a responder perguntas como:
Por qual responsabilidade este serviço responde?
De quais outros sistemas ele depende?
Por que ele foi construído dessa forma?
Qual regra de negócio está sendo usada aqui?
Como sabemos que ele está funcionando corretamente?
O que aconteceu na última vez que esta parte mudou?
Uma arquitetura de contexto bem projetada não elimina a necessidade de raciocínio. Ela reduz o esforço necessário para encontrar a informação certa.
O contexto não precisa estar em um só lugar
Podemos querer colocar tudo em um só lugar. Poderíamos criar uma página grande chamada “Como a empresa funciona” e esperar que todos encontrem ali o que precisam.
Na prática, esse documento fica desatualizado muito rapidamente. Torna-se difícil saber o que ainda é válido, quem deve atualizá-lo e qual parte se aplica a cada situação.
Talvez seja melhor pensar no contexto como uma rede:
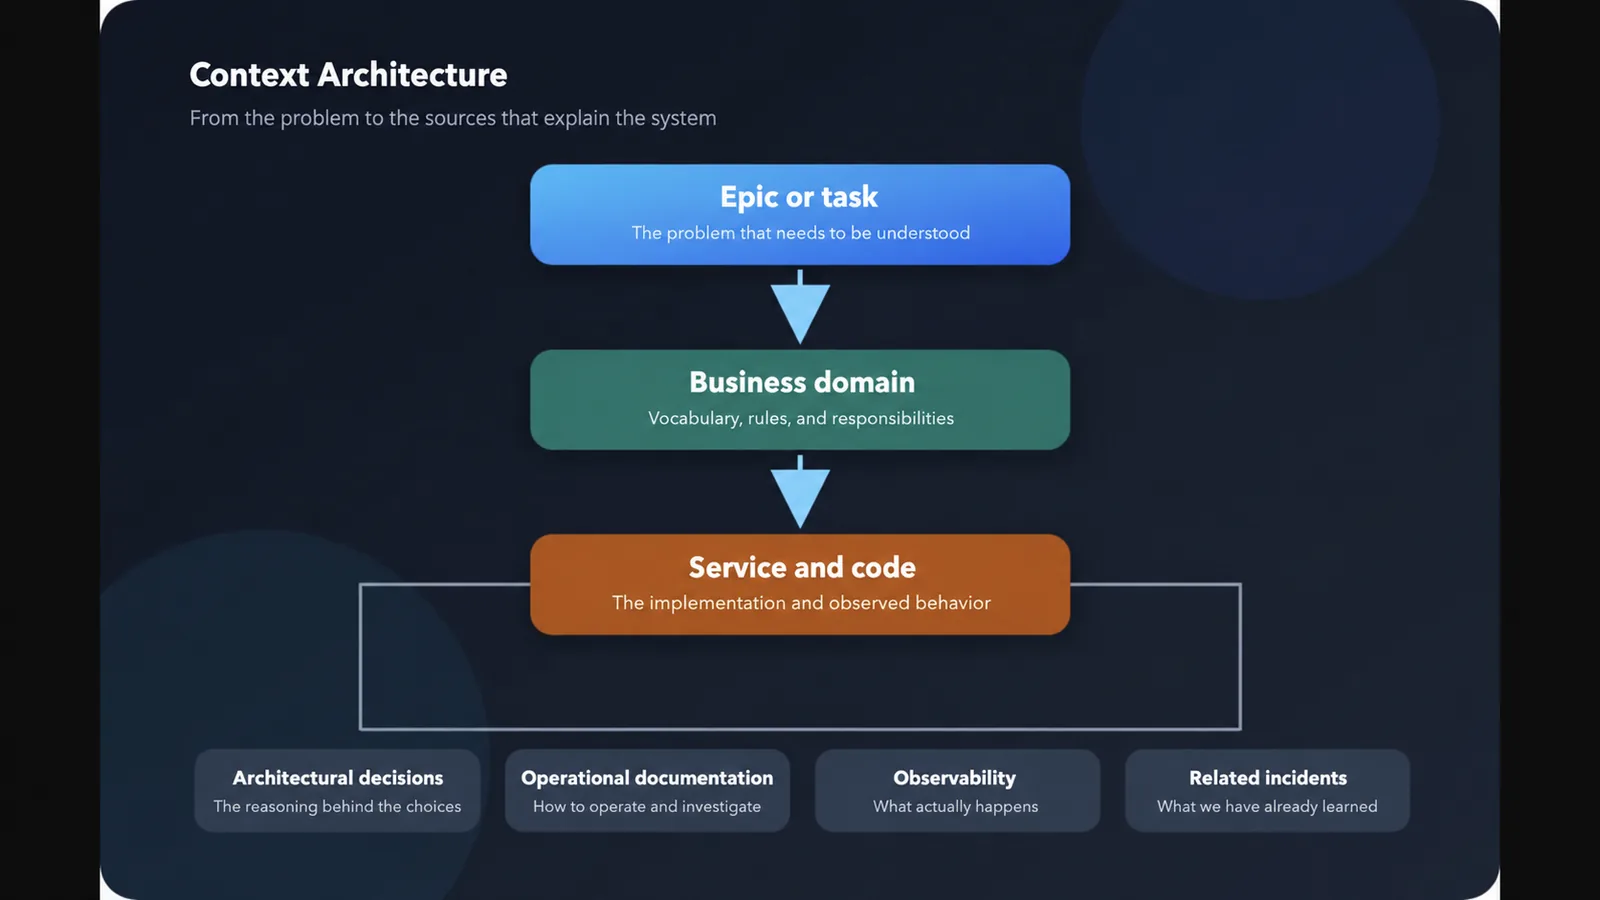
Cada fonte pode permanecer onde funciona melhor. O que muda é que existem links claros entre elas.
Uma tarefa deve apontar para o domínio afetado. O domínio deve apontar para os serviços envolvidos. O serviço deve ter sua documentação operacional. Decisões importantes devem ser registradas. Os sinais de produção também devem ser fáceis de encontrar.
O objetivo não é centralizar o conhecimento. É torná-lo fácil de encontrar.
Exemplo de estrutura
Imagine um domínio de pagamentos. O código pode estar em um repositório, enquanto a documentação, os ADRs e os runbooks permanecem nas ferramentas que o time já usa:
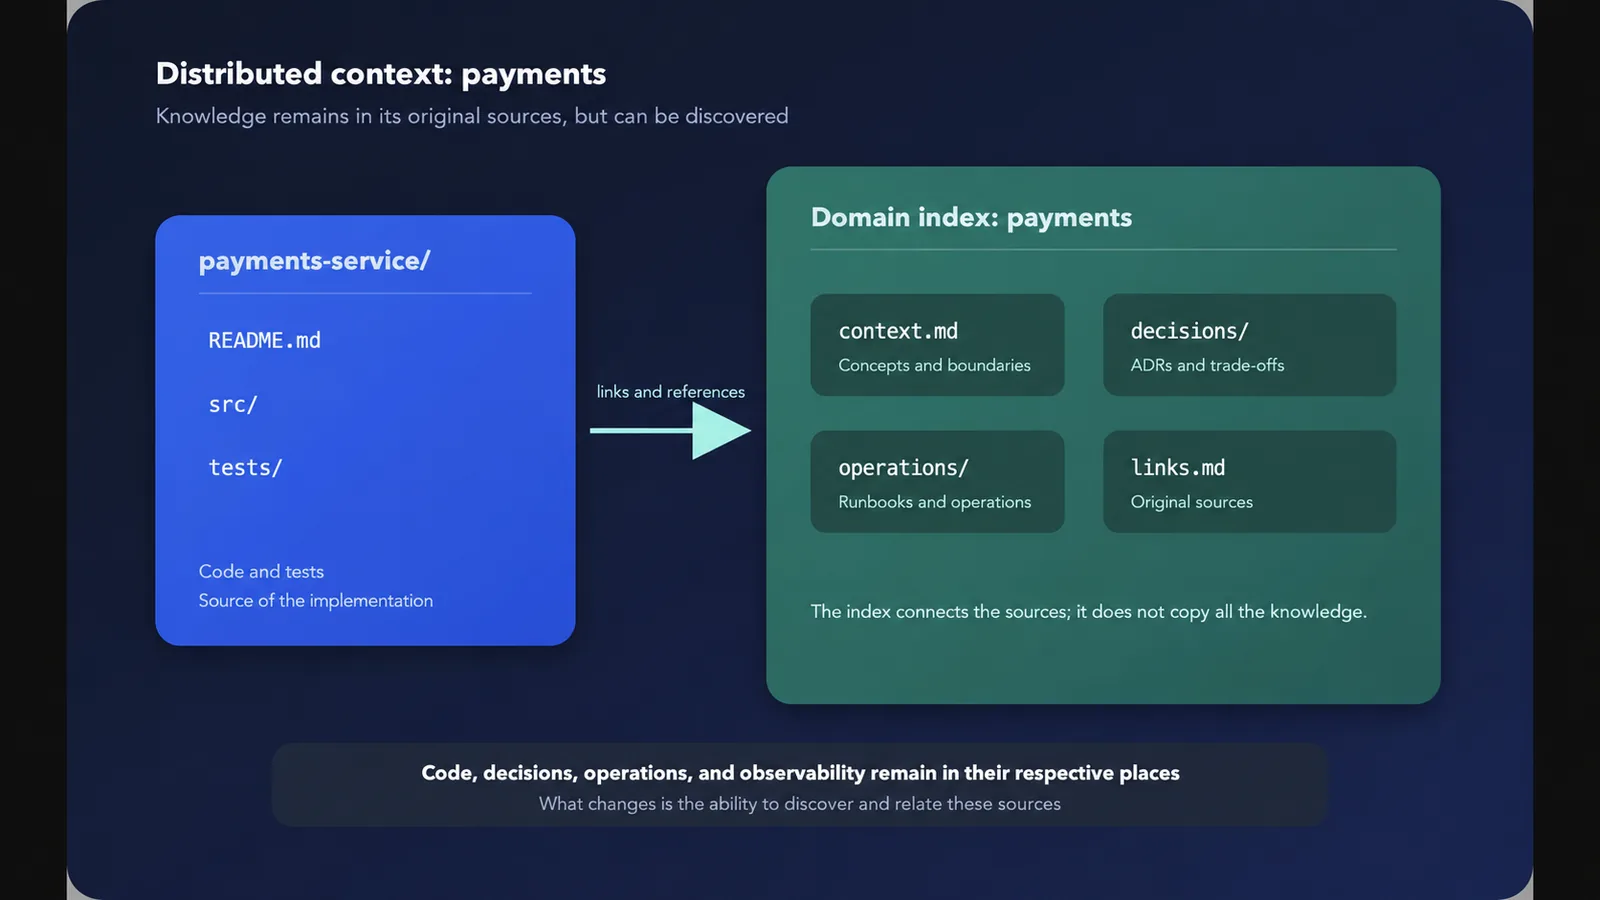
O README.md do repositório pode explicar a responsabilidade do serviço e apontar para o Architecture Hub. A página context.md pode descrever conceitos de negócio e limites de domínio. ADRs podem ficar em uma ferramenta de arquitetura, runbooks em uma plataforma de documentação e dashboards na ferramenta de observabilidade.
O arquivo links.md não precisa copiar o conteúdo dessas fontes. Ele pode funcionar como um índice confiável, com links para onde cada informação está armazenada.
Um agente que recebe uma tarefa de pagamentos não precisa ler imediatamente todos os arquivos do repositório. Pode começar pelo mapa do domínio, seguir os links relacionados à tarefa e consultar cada fonte no momento certo.
A parte mais importante dessa estrutura não é colocar tudo na mesma pasta. É deixar claro onde cada tipo de conhecimento vive e como chegar até ele.
O contexto precisa de um responsável
Documentação sem responsável geralmente acaba abandonada.
Se ninguém souber quem deve atualizar uma página, ela ficará desatualizada. Se uma decisão arquitetural não disser quem a tomou e por quê, mais tarde ela poderá parecer uma regra sem motivo.
Por isso, uma Arquitetura de Contexto também precisa responder:
Quem é responsável por este contexto?
Quando ele foi atualizado pela última vez?
Qual sistema é a fonte original desta informação?
Como sabemos que ela ainda é válida?
Pessoas e agentes de IA precisam disso. Um agente pode encontrar uma página útil, mas ainda precisa verificar se a informação está atualizada, pertence ao sistema correto e é útil para tomar uma decisão.
Contexto sem um sinal claro de validade pode ser tão perigoso quanto não ter contexto algum.
O papel das decisões arquiteturais
Uma das fontes mais valiosas de informação sobre um sistema é o histórico de suas decisões.
O código atual mostra o resultado de muitas escolhas. Um ADR ajuda a explicar essas escolhas.
Ele pode registrar:
o problema que precisava ser resolvido;
as opções que foram consideradas;
os critérios usados para tomar a decisão;
os trade-offs que foram aceitos;
os resultados esperados.
Sem esse histórico, alguém pode olhar para uma implementação e pensar que ela poderia ser muito mais simples. Talvez pudesse. Mas pode ter existido uma restrição que já não está visível no código.
Para um agente, essa diferença é muito importante. Sem o contexto por trás de uma decisão, ele pode sugerir uma mudança tecnicamente elegante que não atende a uma necessidade real de negócio ou a um limite operacional conhecido.
O contexto deve acompanhar o fluxo de trabalho
Outro ponto importante é que o contexto não deve ser tratado como uma atividade separada do desenvolvimento.
Se a documentação for atualizada apenas durante uma grande revisão anual, ela ficará para trás. Se os ADRs forem escritos apenas quando alguém se lembrar de escrevê-los, muitas decisões importantes desaparecerão. Se os incidentes não deixarem aprendizados registrados, o time investigará os mesmos problemas repetidamente.
O contexto precisa fazer parte do fluxo de trabalho normal:
Uma mudança começa com uma tarefa ou um épico.
O time identifica os domínios e serviços afetados.
As decisões importantes são registradas.
A documentação é atualizada junto com o código.
A observabilidade mostra o que acontece depois da implantação.
Incidentes e aprendizados são adicionados à base de conhecimento.
Isso não precisa ser um processo pesado. O importante é criar e manter esses links próximos do momento em que o conhecimento é criado.
O que uma pessoa nova deve conseguir fazer?
Uma boa forma de testar essa arquitetura é escolher uma tarefa real e imaginar uma pessoa nova tentando concluí-la.
Essa pessoa conseguiria descobrir:
qual parte do sistema precisa mudar;
quem é responsável pelo domínio;
quais decisões limitam a solução;
como verificar se a mudança funcionou;
onde investigar se algo der errado?
Se a resposta para todas essas perguntas for “você precisa falar com alguém”, existe uma oportunidade de melhorar o contexto do sistema.
O mesmo teste pode ser usado com um agente de IA. A diferença é que um agente deixará ainda mais claro quando informações importantes dependem de conhecimento informal.
Uma forma simples de medir isso é escolher uma tarefa pequena e observar as etapas necessárias para resolvê-la. Se alguém precisa abrir vários sistemas não relacionados ou perguntar a outra pessoa antes de cada decisão, o problema não é apenas documentação. É um problema de arquitetura de contexto.
Arquitetura de contexto não é burocracia
É possível transformar este tema em mais um conjunto de processos obrigatórios. Não acho que esse seja o objetivo.
O objetivo não é escrever documentação apenas por escrever. É reduzir o tempo que as pessoas gastam procurando respostas e diminuir a dependência das pessoas que estavam presentes quando uma decisão foi tomada.
Uma arquitetura de contexto bem mantida ajuda no onboarding, na investigação de incidentes, no planejamento de funcionalidades e na manutenção do sistema. Os agentes de IA apenas tornam essa necessidade mais fácil de enxergar.
No fim, esta é uma prática antiga diante de um novo desafio: tornar o conhecimento do sistema mais explícito para que ele não permaneça apenas na memória de poucas pessoas.
Conclusão
O código explica como o sistema funciona em um determinado momento. O contexto ajuda a explicar por que ele funciona dessa forma, quais limites existem e como ele se conecta ao restante da organização.
Uma Arquitetura de Contexto não precisa colocar tudo em um único lugar. Ela precisa conectar as fontes corretas, deixar claro quem é responsável por cada contexto e tornar as informações fáceis de encontrar.
Quando fazemos isso, o sistema fica mais fácil de entender para quem está entrando no time, para quem está investigando um problema e para os agentes que trabalham conosco.
No próximo artigo, vou falar sobre observabilidade como fonte de contexto. Logs, métricas e traces não servem apenas para encontrar erros. Eles também ajudam a explicar como o sistema realmente se comporta.
Comentários