Todo sistema falha. A pergunta não é se um serviço vai cair, é o que acontece com o resto quando ele cair. Esse é o assunto da minha palestra Design for Failure, que apresentei na SoftWeek e no PHPeste em 2025, e este artigo é a versão escrita dela, com um pouco mais de espaço para os detalhes que não cabem em 40 minutos de palco.
A ideia da palestra é simples: dar nome aos padrões que a gente já usa, às vezes sem saber. Retry, fallback, circuit breaker e saga não são invenções recentes, e entender de onde vem cada um ajuda a saber quando usar, e principalmente quando não usar.
Um aviso antes de começar: todo código aqui é didático. Ele existe para mostrar a ideia, não para ir direto para produção. Para isso existem bibliotecas testadas, que eu cito no caminho.
De um servidor para muitos pontos de falha
Toda loja virtual começa do mesmo jeito: um servidor, uma aplicação e um banco de dados. Enquanto o servidor usa 20% da capacidade, está tudo bem. Aí a loja cresce, o uso vai para 80%, e é hora de escalar. Existem duas formas de fazer isso:
- Vertical: você melhora o equipamento que já tem. Mais CPU, mais memória, um servidor maior. É simples, mas tem um teto e fica caro rápido.
- Horizontal: você aumenta o número de equipamentos. Mais servidores, containers, um Kubernetes orquestrando tudo. Não tem um teto tão claro, mas agora o sistema é distribuído.
E é no sistema distribuído que você começa a perceber que existem muitos pontos de falha. Uma chamada entre dois serviços pode demorar demais, o outro lado pode ter caído, pode ter um lock segurando um recurso. Cada seta num diagrama de arquitetura é uma chamada de rede, e toda chamada de rede pode falhar.
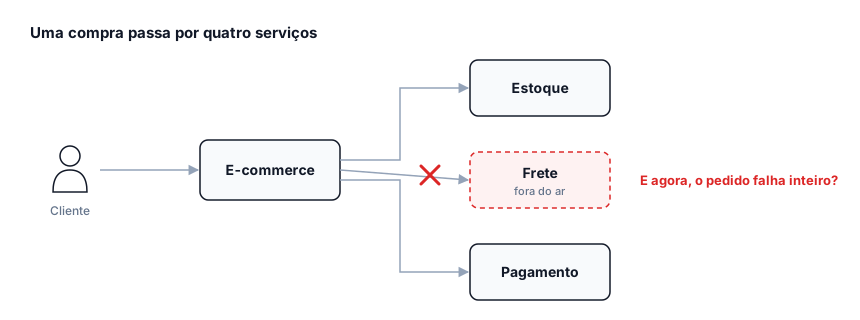
Para o resto do artigo, vamos usar uma loja dividida em serviços. Uma compra passa pelo e-commerce, que fala com o estoque, com o frete e com o pagamento. Se todo mundo responde, o cliente recebe um 200 OK. Mas e se o serviço de frete estiver fora do ar?
Retry: tentar de novo, do jeito certo
A resposta mais natural é tentar de novo. Muitas falhas em rede são temporárias: um pacote perdido, um timeout num momento de pico, um container reiniciando. A segunda tentativa, alguns instantes depois, muitas vezes funciona.
Essa ideia é dos anos 70 e 80, quando as primeiras redes compartilhadas precisavam lidar com colisões: a Ethernet, por exemplo, sorteia quanto esperar antes de transmitir de novo, num intervalo que dobra a cada colisão. É daí que vêm os dois ingredientes de um bom retry:
- Backoff exponencial: o tempo de espera aumenta a cada tentativa (1 s, 2 s, 4 s, 8 s…). Assim você não fica martelando um serviço que já está com dificuldade.
- Jitter: um pouco de aleatoriedade nesse tempo (por exemplo, 4 s ± 20%). Parece detalhe, mas é o que evita que todos os clientes tentem de novo no mesmo instante.
Em PHP, com Guzzle, fica assim:
use GuzzleHttp\Exception\ConnectException;
use GuzzleHttp\Exception\ServerException;

public function callShipping(array $data): array
{
    $maxAttempts = 3;

    for ($attempt = 1; ; $attempt++) {
        try {
            $response = $this->httpClient->post('http://shipping/api/quote', [
                'json' => $data,
                'timeout' => 2,
            ]);

            return json_decode((string) $response->getBody(), true);
        } catch (ConnectException | ServerException $e) {
            if ($attempt === $maxAttempts) {
                throw $e;
            }

            $backoffMs = 1000 * 2 ** ($attempt - 1); // 1 s, 2 s, 4 s...
            $jitter = random_int(-20, 20) / 100;     // ±20%
            usleep((int) ($backoffMs * (1 + $jitter) * 1000));
        }
    }
}
Repare no que não é retentado. O catch pega só falha de conexão e erro 5xx, que são os casos em que tentar de novo pode dar certo. Um 4xx, como um 400 ou um 422, significa que o pedido está errado, e mandar o mesmo pedido três vezes só gera três erros.
Três cuidados que valem para qualquer retry:
- Só repita o que é idempotente. Retentar uma consulta de frete é seguro. Retentar uma cobrança, sem uma chave de idempotência, pode cobrar o cliente duas vezes, porque a primeira tentativa pode ter funcionado e só a resposta se perdeu.
- Conte o tempo total. Com timeout de 2 s e esperas de 1 s e 2 s, o pior caso são 9 segundos. Alguém está esperando do outro lado.
- No PHP-FPM, esperar custa um processo. Aquele
usleepsegura um worker parado sem fazer nada. No Swoole e no Hyperf, a mesma chamada só pausa a corrotina, e o processo segue atendendo outras requisições.
Thundering herd: quando o retry piora tudo
Agora imagine mil clientes chamando o mesmo serviço no momento em que ele cai. Todos falham juntos, todos esperam 1 segundo, e todos tentam de novo juntos. O serviço, que estava tentando se recuperar, recebe mil requisições no mesmo instante e cai de novo. Isso tem nome: thundering herd, a manada trovejante.
O jitter é exatamente o que quebra essa sincronia. Simulei os mil clientes com e sem ele:
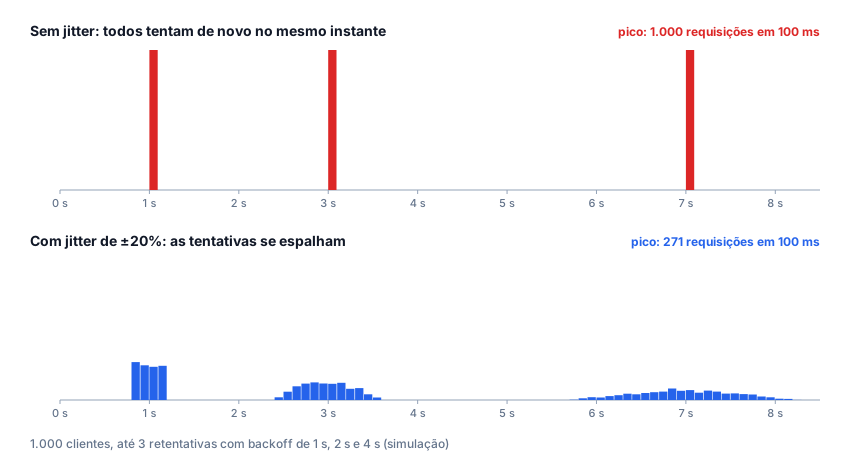
Sem jitter, o serviço recebe 1.000 requisições em 100 ms, três vezes seguidas. Com ±20%, o pico cai para 271. É o mesmo número de tentativas, só que espalhadas. E quanto mais aleatoriedade, mais espalhado: sortear a espera inteira entre zero e o backoff, o chamado full jitter, baixa o pico ainda mais.
Fallback: uma resposta alternativa
O retry resolve falhas rápidas. Mas e quando o frete fica fora do ar por dez minutos? Tentar três vezes e devolver erro para o cliente significa que nenhuma compra fecha nesse período, por causa de um único serviço.
É aqui que entra o fallback, uma ideia que ganhou força nos anos 90 e 2000 junto com os conceitos de alta disponibilidade e graceful degradation: quando um serviço crítico falha, o sistema não para inteiro, ele devolve uma resposta alternativa. Pode ser um valor padrão, uma resposta em cache ou um valor calculado antes.
No exemplo da loja, se o frete não responde, dá para usar o último valor calculado para aquele CEP ou um frete padrão:
private const DEFAULT_SHIPPING = ['price' => 29.90, 'days' => 10];

public function shippingQuote(array $data): array
{
    try {
        return $this->callShipping($data);
    } catch (ConnectException | ServerException $e) {
        $this->logger->warning('Shipping unavailable, using fallback', [
            'error' => $e->getMessage(),
        ]);

        return $this->cache->get("shipping:{$data['zip']}", self::DEFAULT_SHIPPING);
    }
}
A compra continua. O cliente talvez pague um frete um pouco diferente, mas consegue comprar.
Duas coisas importantes sobre fallback:
- Ele é uma decisão de negócio, não só técnica. Um frete padrão pode sair mais caro para a loja do que o real, e alguém precisa concordar com isso. E nem tudo tem fallback: não existe “pagamento padrão”.
- Passar pelo fallback nunca é um bom sinal. Ele mantém o sistema de pé, mas esconde o problema. Por isso o log ali dentro não é enfeite: todo fallback precisa de métrica e alerta, senão o frete pode ficar fora do ar uma semana sem ninguém perceber.
Circuit breaker: parar de bater em cachorro morto
Com retry e fallback, o cliente é atendido. Mas olhe o que está acontecendo por baixo: a cada compra, o e-commerce tenta o frete três vezes, espera os timeouts, e só aí vai para o fallback. Multiplique isso por todas as compras e o serviço de frete, que caiu, continua recebendo uma enxurrada de chamadas. É bater em cachorro morto: ninguém ganha nada, e ainda atrapalha a recuperação.
O ideal seria o serviço de frete poder dizer “para de tentar aí, ainda tô me recuperando”. Como ele não pode, quem chama precisa perceber sozinho. Essa é a função do circuit breaker, inspirado nos disjuntores elétricos e popularizado pelo livro Release It!, de Michael Nygard, em 2007. Quando a falha passa de um limite, o disjuntor “desarma” e corta as chamadas por um tempo.
Ele tem três estados:
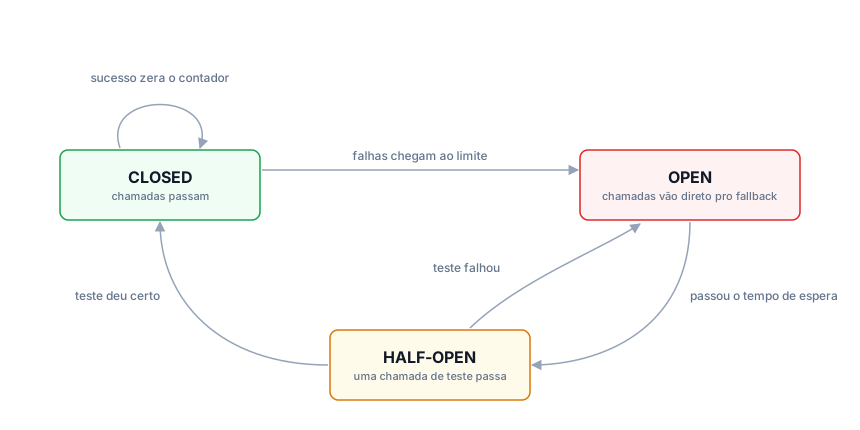
- CLOSED: o normal. As chamadas passam, e as falhas são contadas.
- OPEN: as falhas chegaram ao limite. Nenhuma chamada sai; tudo vai direto para o fallback, sem esperar timeout. O serviço do outro lado ganha um respiro.
- HALF-OPEN: passou o tempo de espera. Uma chamada de teste é liberada. Se der certo, o circuito fecha e a vida segue. Se der errado, abre de novo e a contagem recomeça.
Uma versão enxuta em PHP:
enum CircuitState
{
    case Closed;
    case Open;
    case HalfOpen;
}

final class CircuitBreaker
{
    private CircuitState $state = CircuitState::Closed;
    private int $failures = 0;
    private ?int $openedAt = null;

    public function __construct(
        private int $threshold = 5, // falhas seguidas para abrir
        private int $cooldown = 60, // segundos até liberar um teste
    ) {}

    public function canExecute(): bool
    {
        if ($this->state === CircuitState::Open
            && time() - $this->openedAt >= $this->cooldown) {
            $this->state = CircuitState::HalfOpen; // libera uma chamada de teste
            return true;
        }

        return $this->state === CircuitState::Closed;
    }

    public function onSuccess(): void
    {
        $this->failures = 0;
        $this->state = CircuitState::Closed;
    }

    public function onFailure(): void
    {
        $this->failures++;

        if ($this->state === CircuitState::HalfOpen || $this->failures >= $this->threshold) {
            $this->state = CircuitState::Open;
            $this->openedAt = time();
        }
    }
}
E o uso, juntando com o retry e o fallback:
public function shippingQuote(array $data): array
{
    if (! $this->breaker->canExecute()) {
        return $this->shippingFallback($data);
    }

    try {
        $quote = $this->callShipping($data); // já com retry
        $this->breaker->onSuccess();

        return $quote;
    } catch (ConnectException | ServerException $e) {
        $this->breaker->onFailure();

        return $this->shippingFallback($data);
    }
}
Com o circuito aberto, a compra não espera mais nove segundos para cair no fallback: ela vai direto. O cliente é atendido mais rápido e o frete para de apanhar.
Um detalhe que pega muita gente no PHP: onde esse estado mora? No PHP-FPM, cada requisição começa do zero, então um objeto CircuitBreaker em memória esquece tudo ao final de cada requisição e nunca abre. O estado precisa ficar num lugar compartilhado, como Redis ou APCu. No Swoole e no Hyperf, o processo continua vivo entre requisições, e o estado em memória funciona por worker. O Hyperf, inclusive, já tem componentes prontos para isso, o hyperf/retry e o hyperf/circuit-breaker.
E, como no fallback, um circuito abrindo é um evento que alguém precisa ver. Ele deve gerar alerta e aparecer no seu monitoramento.
Saga: e a consistência?
Até aqui, cada padrão lidou com uma chamada que falha. Mas uma compra é um conjunto de passos: reservar o estoque, cobrar o pagamento, agendar a entrega. E se o estoque foi reservado e o pagamento cobrado, mas a entrega falhou?
Num banco de dados só, isso seria uma transação: ou tudo acontece, ou nada acontece. Mas cada serviço tem o seu banco, e não existe uma transação que abrace todos eles. A resposta para isso é a saga, descrita por Hector Garcia-Molina e Kenneth Salem em 1987: uma sequência de transações locais em que cada ação tem a sua compensação correspondente. Reservou estoque? A compensação é liberar a reserva. Cobrou? A compensação é estornar.
Para o usuário, a operação parece atômica, mas tecnicamente a consistência é eventual. O sistema garante o “tudo ou nada” não por uma transação de verdade, mas pela capacidade de desfazer cada passo se o processo falhar.
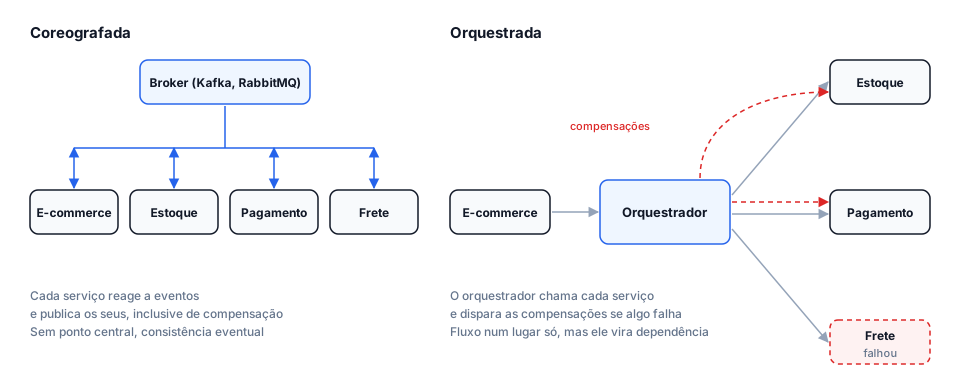
Existem duas formas principais de coordenar uma saga:
Coreografada
Ninguém coordena: cada serviço reage a eventos e publica os seus. Quando algo falha, quem percebe publica um evento, e cada serviço desfaz a própria parte. Na palestra usei o event dispatcher do Hyperf para o exemplo ficar curto. Entre serviços diferentes, esse evento viaja por um broker como Kafka ou RabbitMQ, e o listener vira um consumidor.
Quem percebe a falha publica o evento:
} catch (ConnectException | ServerException $e) {
    $this->breaker->onFailure();

    $this->eventDispatcher->dispatch(new OrderCancelled(
        orderId: $data['order_id'],
        reason: 'Shipping failed: ' . $e->getMessage(),
    ));
}
E cada serviço cuida da sua compensação. No estoque, por exemplo:
use Hyperf\Event\Contract\ListenerInterface;

final class ReleaseStockOnOrderCancelled implements ListenerInterface
{
    public function __construct(private StockRepository $stock) {}

    public function listen(): array
    {
        return [OrderCancelled::class];
    }

    public function process(object $event): void
    {
        // Idempotente: o mesmo evento pode chegar duas vezes.
        $this->stock->releaseReservation($event->orderId);
    }
}
O ponto forte é o desacoplamento: não existe um serviço central que, se cair, para tudo. O ponto fraco é que o fluxo não está escrito em lugar nenhum. Ele existe espalhado pelos listeners, e entender “o que acontece quando um pedido é cancelado” exige olhar vários serviços. Falei mais sobre esse estilo no artigo sobre Event-Driven Architecture.
Orquestrada
Um orquestrador conhece o fluxo inteiro: chama cada serviço na ordem e, se algum falhar, dispara as compensações dos passos que já aconteceram, na ordem inversa:
final class PlaceOrderSaga
{
    public function run(Order $order): void
    {
        $compensations = [];

        try {
            $this->stock->reserve($order);
            $compensations[] = fn () => $this->stock->release($order);

            $this->payment->charge($order);
            $compensations[] = fn () => $this->payment->refund($order);

            $this->shipping->schedule($order);
        } catch (Throwable $e) {
            foreach (array_reverse($compensations) as $compensate) {
                $compensate();
            }

            throw new OrderFailed("Order {$order->id} failed", previous: $e);
        }
    }
}
Se a entrega falha, o pagamento é estornado e depois o estoque é liberado. O fluxo está num lugar só, fácil de ler e de testar. Em troca, o orquestrador vira uma peça central: se ele cai, nenhuma saga anda.
Num sistema real, falta uma coisa nesse código: guardar o estado da saga. Se o orquestrador cair no meio de uma compensação, ele precisa saber, ao voltar, onde parou. E uma compensação também pode falhar, então ela precisa de retry e precisa ser idempotente. É por isso que, em produção, sagas costumam rodar em cima de ferramentas como Temporal ou de uma tabela de estado bem cuidada.
Os tipos de saga
O livro Software Architecture: The Hard Parts (Ford, Richards, Sadalage e Dehghani) organiza as sagas por três escolhas: comunicação síncrona ou assíncrona, consistência atômica ou eventual, e coordenação orquestrada ou coreografada. Na palestra mostrei três das combinações:
| Comunicação | Consistência | Coordenação | |
|---|---|---|---|
| Epic Saga | Síncrona (HTTP) | Atômica | Orquestrada |
| Parallel Saga | Assíncrona (Kafka) | Eventual | Orquestrada |
| Anthology Saga | Assíncrona (Kafka) | Eventual | Coreografada |
A Epic Saga é a mais parecida com o código acima: o orquestrador chama cada serviço por HTTP, espera a resposta, e nenhum serviço fala com outro diretamente. A Parallel Saga mantém o orquestrador, mas conversa por mensagens, o que permite executar passos em paralelo. A Anthology Saga é a coreografada pura: sem orquestrador, cada serviço mantém a sua transação e trata o próprio rollback. Quanto mais para baixo na tabela, menos acoplamento e mais escala, e mais difícil entender o que está acontecendo.
Juntando tudo
Numa arquitetura real, esses padrões aparecem juntos. A chamada ao frete tem retry com backoff e jitter, um circuit breaker em volta, um fallback com o último valor calculado e um log de cada tentativa e falha. A compra inteira é uma saga, que desfaz os passos se algo der errado no meio.
Agora os seus sistemas podem falhar tranquilamente.
Ou talvez não.
Cada padrão desses resolve um problema e cria outro. O retry aumenta a carga no serviço que já está mal. O fallback esconde a falha e pode custar dinheiro. O circuit breaker precisa de estado compartilhado e de limites bem calibrados, senão abre à toa ou não abre nunca. A saga troca uma transação simples por consistência eventual, compensações e muito mais código. Tudo é trade-off.
Então não se apeguem a padrões. Identifique o que faz mais sentido para o seu contexto: qual falha é provável, quanto ela custa, quanto tempo alguém pode esperar, e qual resposta errada é aceitável. Não existe bala de prata.
Os slides da palestra estão no Speaker Deck. Se você já passou por uma falha em cascata, ou usa algum desses padrões de um jeito diferente, me conta nos comentários.
Comentários