Durante um bom tempo meu blog morou no Hashnode, e funcionava bem. O problema apareceu quando comecei a escrever em inglês e português: o Hashnode não tem suporte de verdade a dois idiomas, então eu publicava cada artigo duas vezes, como se fossem posts diferentes, sem nada ligando um ao outro.
Comentei isso com o Leo Cavalcante, e ele me apresentou o Hugo. Fica aqui o meu agradecimento, Leo: essa conversa virou o blog que você está lendo agora.
Com o Hugo eu ganhei bem mais flexibilidade. Neste post eu conto como montei tudo: os dois idiomas, as palestras que se atualizam sozinhas, as imagens de prévia geradas automaticamente e o deploy que roda todo dia sem eu encostar em nada.
Atualizado em 8 de outubro de 2026: de lá pra cá entraram os artigos antigos traduzidos, um aviso de idioma, temas, “Leia também”, comentários e a medição de cliques. Está tudo nas seções novas abaixo.
Um lugar só para os dois idiomas
No Hugo, cada artigo é um arquivo de texto no repositório, e a tradução é só outro arquivo ao lado dele. O Hugo entende que os dois são o mesmo artigo: a versão em inglês fica em luizschons.com, a em português em /pt-br/, e cada uma tem um link para a outra.
Na prática, a pasta de artigos fica assim:
content/posts/
├── agent-observability-with-opentelemetry.md        # inglês
├── agent-observability-with-opentelemetry.pt-br.md  # português
├── hash-tables.md                                   # inglês
└── tabelas-hash.pt-br.md                            # português
O que liga as duas versões é o translationKey no front matter, e no hugo.toml basta declarar os idiomas:
---
title: 'Observabilidade de Agentes com OpenTelemetry'
date: 2026-09-16
series: ['Arquitetura Amigável à IA']
translationKey: agent-observability-with-opentelemetry
---
defaultContentLanguage = 'en'
[languages.en]
languageCode = 'en-us'
weight = 1
[languages."pt-br"]
languageCode = 'pt-br'
weight = 2Isso resolveu o que me incomodava no Hashnode. Um artigo, duas versões, tudo no mesmo lugar, e o Google entende que são a mesma página em idiomas diferentes. O visual veio de um tema chamado Hextra, que eu fui adaptando com layouts próprios até ficar com a minha cara.
Os nomes dos arquivos não precisam ser iguais: hash-tables.md e tabelas-hash.pt-br.md são o mesmo artigo porque têm o mesmo translationKey. Assim cada idioma ganha uma URL que faz sentido nele.
Um aviso, não um redirect
Muita gente chega pelo Google ou por um link compartilhado na versão “errada” para ela. Eu não quis redirecionar ninguém automaticamente, porque isso atrapalha o Google e irrita quem prefere ler no outro idioma. Em vez disso, quando existe a tradução, aparece um aviso discreto no rodapé: “Esta página também está disponível em português”.
O aviso só aparece quando o idioma preferido do navegador, entre português e inglês, é o da outra versão. Se a pessoa fecha o aviso ou troca de idioma pelo menu, isso fica guardado no navegador e ele não volta mais:
var langs = navigator.languages.map(function (l) { return l.toLowerCase(); });
// a primeira preferência entre os dois idiomas que o site tem
var top = langs.filter(function (l) { return l.startsWith('pt') || l.startsWith('en'); })[0] || '';
var wants = target === 'pt-br' ? top.startsWith('pt') : !top.startsWith('pt');
if (wants && !localStorage.getItem('langSuggestDismissed')) box.hidden = false;
Trazendo os artigos antigos
Os artigos que vieram do Hashnode tinham três problemas. Muitos existiam só em português. As URLs tinham um hash no fim, como quicksort-33f8e917ab6c. E o código aparecia como parágrafo comum, sem cor e com quebra de linha manual.
Traduções com a data original. Cada artigo que só existia em português ganhou a versão em inglês com a mesma data do original. Assim a tradução entra no lugar certo da lista, e não aparece como se eu tivesse publicado onze artigos num dia só. Hoje todos os artigos existem nos dois idiomas.
URLs limpas sem quebrar links. Renomear um arquivo muda a URL, e quem tinha o link antigo (inclusive o Google) cairia num 404. Para cada endereço antigo existe uma página fixa em static/ que só redireciona para o novo:
<!-- static/posts/quicksort-33f8e917ab6c/index.html -->
<link rel="canonical" href="https://luizschons.com/pt-br/posts/quicksort/">
<meta name="robots" content="noindex">
<meta http-equiv="refresh" content="0; url=https://luizschons.com/pt-br/posts/quicksort/">
O Hugo tem aliases no front matter para isso, mas as versões novas colocam os aliases de páginas em português dentro de /pt-br/, e os links antigos ficavam na raiz. Páginas fixas não dependem da versão do Hugo.
Código de verdade. Os blocos que vieram como <p> com <br /> viraram blocos de código com a linguagem marcada. Aí o Hugo colore o código no build, sem JavaScript, e o tema põe o botão de copiar. Aproveitei para dar uma descrição (alt) a todas as imagens e para trocar as tabelas que eram imagem por tabelas de verdade, que agora aparecem traduzidas na versão em inglês.
Palestras direto do Sessionize
Todas as minhas palestras e os eventos em que palestrei/organizei já estavam no Sessionize. Manter a mesma lista no blog seria trabalho dobrado de novo, então o blog passou a ler os dados de lá.
O Sessionize tem uma API pública que devolve o perfil, as palestras e os eventos em JSON. A página de palestras usa esse JSON duas vezes: na hora em que o site é gerado e de novo no navegador de quem abre a página. Na prática, eu cadastro um evento no Sessionize e em poucos minutos ele aparece no blog, separado entre próximos e passados.
No build, um script de poucas linhas salva o JSON em data/, onde o Hugo o enxerga como site.Data.sessionize:
URL = "https://sessionize.com/api/speaker/json/2n3e2etaad"
OUTPUT = "data/sessionize.json"

request = urllib.request.Request(URL, headers={"User-Agent": "hugo-sessionize-sync/1.0"})
with urllib.request.urlopen(request, timeout=30) as response:
    profile = json.load(response)

with open(OUTPUT, "w", encoding="utf-8") as file:
    json.dump(profile, file, ensure_ascii=False, indent=2)
O template separa os eventos pela data de fim, comparando com o dia do build:
{{- $today := time.AsTime (now.Format "2006-01-02") -}}
{{- range site.Data.sessionize.events -}}
  {{- if ge (time.AsTime .eventEndDate).Unix $today.Unix -}}
    {{- $upcoming = $upcoming | append . -}}
  {{- else -}}
    {{- $past = $past | append . -}}
  {{- end -}}
{{- end -}}
No navegador, o mesmo JSON é buscado de novo. O Sessionize libera CORS, então basta um fetch. Se falhar, a página fica com a versão do build e mostra o link do perfil:
fetch('https://sessionize.com/api/speaker/json/2n3e2etaad')
  .then(r => { if (!r.ok) throw new Error('HTTP ' + r.status); return r.json(); })
  .then(render)   // redesenha eventos, palestras, números e foto
  .catch(fail);   // mostra o aviso com o link do perfil
A foto de perfil segue a mesma ideia. Ela vem do Sessionize na home, na página de palestras, no ícone do site e nas imagens de prévia: trocou lá, troca aqui.
E se o Sessionize sair do ar? A página continua mostrando a última versão salva, com um link para o meu perfil, e a foto cai numa cópia guardada no próprio blog.
O fallback da foto é só HTML, então funciona mesmo antes de o JavaScript carregar:
<img src="https://cdn.sessionize.com/image/..."
     onerror="this.onerror=null;this.src='/images/profile-fallback.jpg'">
Imagens de prévia que se fazem sozinhas
Quando alguém compartilha um link no LinkedIn ou no WhatsApp, o que chama atenção é a imagem do card. Eu não queria abrir o Canva a cada artigo novo, então o próprio Hugo gera essa imagem.
Na hora de montar o site, ele desenha uma imagem por página, nos dois idiomas, com o título do artigo, o nome da série quando existe, minha foto e meu nome. Publiquei um artigo, a imagem já vem junto. Se eu trocar a foto no Sessionize, todas as imagens passam a usar a nova no próximo deploy.
Esta é a imagem que o blog gerou para o último artigo da série sobre arquitetura amigável à IA:
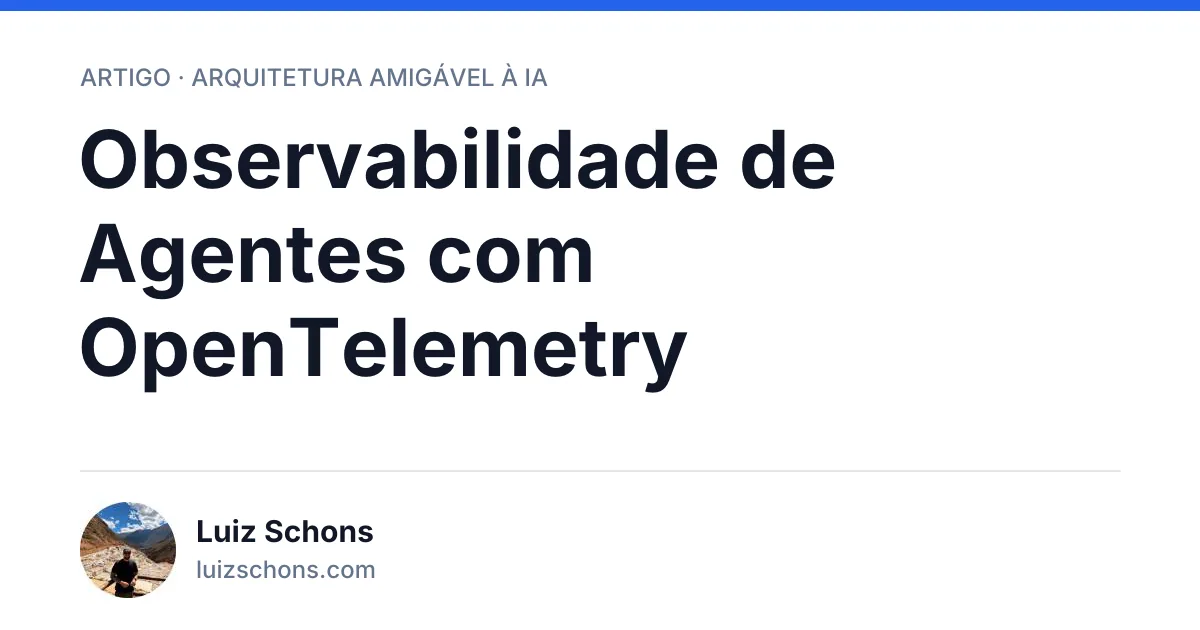
Não tem serviço externo nem headless browser: são os filtros de imagem do próprio Hugo aplicados sobre um fundo branco. O coração do partial og-image.html é isto:
{{- $filters := slice
  (images.Text $kicker (dict "font" $medium "size" 24 "color" "#64748b" "x" 80 "y" 62))
-}}
{{- range $i, $l := $lines -}}
  {{- $filters = $filters | append
      (images.Text $l (dict "font" $bold "size" $size "color" "#111827" "x" 78 "y" (add 110 (mul $i $lineHeight)))) -}}
{{- end -}}

{{- with resources.Get "images/profile.jpg" -}}
  {{- $avatar := .Fill "96x96 Center q90" | images.Filter (images.Mask (resources.Get "og/avatar-mask.png")) -}}
  {{- $filters = $filters | append (images.Overlay $avatar 80 502) -}}
{{- end -}}

{{- $img := resources.Get "og/base.png" | images.Filter $filters -}}
{{- return ($img | resources.Copy (printf "og/%s-%s.png" $page.Language.Lang (md5 $title))) -}}
O título é quebrado em linhas antes ($lines), com o tamanho da fonte escolhido pelo comprimento. Depois é só apontar as meta tags para a imagem:
{{- with partialCached "og-image.html" . .RelPermalink }}
<meta property="og:image" content="{{ .Permalink }}">
<meta name="twitter:card" content="summary_large_image">
{{- end }}
Temas, “Leia também” e comentários
Cada artigo tem alguns temas no front matter, como tags: ['PHP', 'Performance'], nos nomes do idioma do arquivo. O Hugo gera sozinho uma página por tema (PHP, por exemplo), e eles aparecem como filtros no topo da lista de artigos.
No fim de cada artigo, o bloco “Leia também” sugere até três artigos parecidos. Quem escolhe é o próprio Hugo, com a função .Related, que dá pontos para o que os artigos têm em comum:
[related]
  includeNewer = true
  threshold = 20
  [[related.indices]]
    name = 'tags'     # temas em comum pesam mais
    weight = 100
  [[related.indices]]
    name = 'series'
    weight = 60
  [[related.indices]]
    name = 'date'     # desempate: artigos de épocas próximas
    weight = 5
{{- with first 3 (site.RegularPages.Related . | complement (slice .)) }}
{{- range . }}<a href="{{ .RelPermalink }}">{{ .Title }}</a>{{ end }}
{{- end }}Os comentários usam o giscus, que guarda cada conversa como uma Discussion no repositório do blog. Não tem banco de dados nem anúncio, e para comentar basta uma conta no GitHub. O detalhe que eu mais gostei: as versões em inglês e português de um artigo dividem a mesma conversa, porque a chave da conversa é o translationKey, e não a URL:
<script src="https://giscus.app/client.js"
  data-repo="sschonss/meu-blog"
  data-mapping="specific"
  data-term="posts/{{ .Params.translationKey }}"
  data-lang="{{ if eq site.Language.Lang "pt-br" }}pt{{ else }}en{{ end }}"
  data-loading="lazy" async></script>
O blog se atualiza todo dia
O site é estático e fica no GitHub Pages. Quem monta e publica é um workflow do GitHub Actions, que roda em três situações: quando eu faço push, todo dia de manhã e quando eu clico em “Run workflow”.
A cada execução ele busca os dados no Sessionize, gera o ícone e as imagens de prévia, monta o site com o Hugo e publica. A rodada diária é o que mantém palestras e foto em dia, mesmo nas semanas em que eu não escrevo nada. Ela também publica artigos agendados: se eu deixo um artigo pronto com uma data futura, o Hugo o ignora até o dia chegar, e a rodada daquela manhã coloca ele no ar.
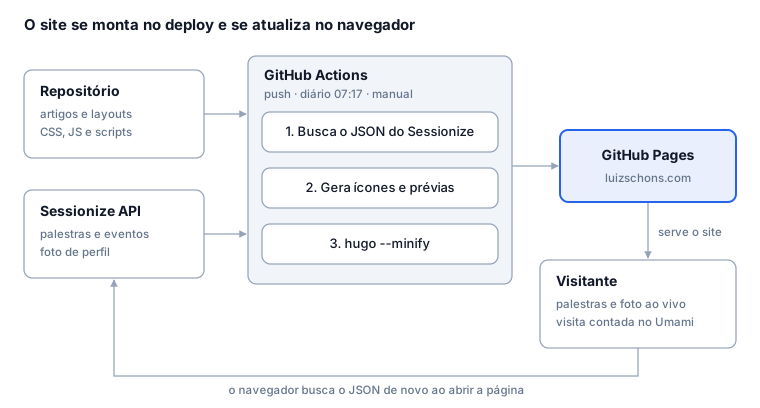
O workflow inteiro cabe numa tela. O cron roda às 10:17 UTC, que é 7:17 em Brasília, e cada passo que depende do Sessionize tem um || echo para não derrubar o deploy:
on:
  push:
    branches: [main]
  workflow_dispatch:
  schedule:
    - cron: '17 10 * * *'

permissions:
  contents: read
  pages: write
  id-token: write

jobs:
  deploy:
    runs-on: ubuntu-latest
    environment:
      name: github-pages
    steps:
      - uses: actions/checkout@v4
        with:
          submodules: recursive        # o tema Hextra é um submódulo
      - name: Refresh Sessionize data
        run: python3 scripts/sync_sessionize.py || echo "usando dados commitados"
      - uses: actions/setup-python@v5
        with:
          python-version: '3.12'
      - name: Build favicons and backup photo
        run: |
          pip install --quiet pillow
          python3 scripts/build_favicons.py || echo "usando ícones commitados"
      - uses: peaceiris/actions-hugo@v3
        with:
          hugo-version: 'latest'
          extended: true
      - run: hugo --minify
      - uses: actions/upload-pages-artifact@v3
        with:
          path: ./public
      - uses: actions/deploy-pages@v4
Repare em contents: read: o workflow só lê o repositório e nunca escreve nele.
Uma escolha que eu gostei: o workflow nunca faz commit no repositório. Os dados do Sessionize são buscados na hora do build, então eu pude proteger a branch main para só eu conseguir enviar mudanças. Se o Sessionize falhar no meio do caminho, o build segue com a última versão salva.
A proteção é um ruleset na main com três regras (restringir updates, restringir exclusão e bloquear force push) e um único bypass: o papel de admin do repositório, que só eu tenho. Como o GitHub Actions não pode ser exceção num ruleset de repositório pessoal, esse desenho só funciona porque o workflow não precisa commitar nada.
Medindo sem cookies
Hoje eu escrevo em um lugar só, nos dois idiomas, e o resto se ajeita sozinho: palestras, foto, imagens de prévia, temas e deploy. As visitas eu acompanho com o Umami, que não usa cookies e por isso dispensa aquele banner chato.
O script só entra no build de produção e só conta o domínio real, então rodar o hugo server localmente não suja os números:
{{ if hugo.IsProduction }}
<script defer src="https://cloud.umami.is/script.js"
        data-website-id="..." data-domains="luizschons.com"></script>
{{ end }}
Além das visitas, o Umami recebe eventos de clique: palestras e eventos abertos, troca de idioma, navegação entre artigos e links externos. Um único arquivo escuta os cliques da página toda e reconhece o tipo de link. A chamada para o Umami fica protegida, porque ele pode não ter carregado ou estar bloqueado, e medir nunca pode quebrar a página:
function track(name, props) {
  try { if (window.umami) window.umami.track(name, props); } catch (e) {}
}

document.addEventListener('click', function (e) {
  var a = e.target.closest('a[href]');
  if (a && a.hostname !== location.hostname)
    track('outbound', { host: a.hostname, from: location.pathname });
});
Com isso eu sei, por exemplo, quantas pessoas trocam de idioma pelo aviso e quais palestras recebem mais cliques.
Para fechar
O código está aberto em github.com/sschonss/meu-blog, com um README explicando cada parte. Se você também escreve em mais de um idioma e está cansado de publicar tudo duas vezes, dá uma olhada e me chama no LinkedIn se quiser trocar ideia.
Comentários